Ein CRM-Datenmodell wirkt auf den ersten Blick wie ein technisches Detail. Accounts, Kontakte, Opportunities, Aktivitäten, einige zusätzliche Felder – fertig.
In der Praxis entscheidet das Datenmodell jedoch darüber, wie gut ein CRM in zwei, fünf oder zehn Jahren noch funktioniert.
Wer Beziehungen zwischen Kunden, Ansprechpartnern, Standorten, Verträgen, Projekten oder Partnern falsch modelliert, merkt die Folgen oft nicht beim Go-live. Die Probleme entstehen später: Reports werden kompliziert, Integrationen benötigen Sonderlogik, Benutzer pflegen dieselben Informationen mehrfach und neue Prozesse lassen sich nur noch mit Workarounds abbilden.
Ein gutes CRM-Datenmodell bildet deshalb nicht einfach vorhandene Excel-Tabellen nach. Es übersetzt das Geschäftsmodell in eine Struktur, die verständlich, auswertbar, integrierbar und erweiterbar bleibt.
Was ist ein CRM-Datenmodell?
Das CRM-Datenmodell definiert, welche Geschäftsobjekte im CRM existieren und wie sie miteinander verbunden sind.
Typische Objekte sind beispielsweise:
- Unternehmen / Accounts
- Ansprechpartner / Contacts
- Leads
- Opportunities
- Produkte
- Angebote
- Verträge
- Projekte
- Servicefälle
- Standorte
- Partner
- Assets oder installierte Produkte
Entscheidend ist jedoch nicht nur, welche Objekte existieren.
Mindestens genauso wichtig sind deren Beziehungen.
Ein Account kann beispielsweise mehrere Ansprechpartner besitzen. Eine Opportunity kann mehreren Ansprechpartnern zugeordnet sein. Ein Konzern kann aus mehreren rechtlich eigenständigen Accounts bestehen. Ein Vertrag kann mehrere Produkte und Standorte umfassen.
Genau diese Beziehungen bestimmen später, welche Fragen das CRM beantworten kann.
Das Datenmodell ist die Geschäftslogik unterhalb der Oberfläche
CRM-Projekte konzentrieren sich verständlicherweise stark auf Benutzeroberflächen.
Welche Felder sollen auf der Maske stehen? Welche Informationen benötigt der Vertrieb? Wie sieht das Dashboard aus?
Diese Fragen sind wichtig. Sie liegen aber eine Ebene oberhalb des eigentlichen Problems.
Unter der Oberfläche muss geklärt sein:
Was ist eigentlich ein Kunde?
Ist der Kunde:
- ein rechtliches Unternehmen,
- eine Unternehmensgruppe,
- ein Standort,
- eine Abteilung,
- ein Vertragspartner,
- oder eine Kombination daraus?
Diese Frage klingt trivial, kann aber erhebliche Auswirkungen haben.
Ein Maschinenbauer verkauft beispielsweise an einen Konzern mit 40 Standorten. Rechnungen gehen an eine zentrale Gesellschaft, Maschinen stehen jedoch an einzelnen Werken und Service wird lokal erbracht.
Wird alles als ein Account geführt, fehlt die Standortperspektive.
Werden dagegen 40 vollständig unabhängige Accounts angelegt, geht möglicherweise die Konzernsicht verloren.
Ein gutes Datenmodell muss beide Perspektiven ermöglichen.
Warum schlechte Datenmodelle anfangs häufig funktionieren
Das Gefährliche an einem schlechten CRM-Datenmodell ist: Es funktioniert zunächst oft erstaunlich gut.
Bei 500 Kunden, drei Vertriebsmitarbeitern und wenigen Prozessen lässt sich fast alles mit zusätzlichen Feldern lösen.
Ein Feld „Vertrag läuft bis“ funktioniert.
Ein Feld „Partner“ funktioniert.
Ein Feld „Standort“ funktioniert.
Ein Feld „Produkt 1“ funktioniert ebenfalls.
Die Probleme entstehen erst, wenn das Unternehmen wächst.
Was passiert beispielsweise, wenn ein Kunde:
- fünf Verträge besitzt,
- zehn Standorte hat,
- 25 Produkte verwendet,
- zwei Partner beteiligt sind,
- unterschiedliche Ansprechpartner pro Produkt besitzt,
- mehrere laufende Projekte hat?
Jetzt reicht ein einzelnes Feld nicht mehr aus.
Das CRM benötigt eigene Objekte und Beziehungen.
Die entscheidende Designfrage lautet deshalb nicht nur:
„Funktioniert das heute?“
Sondern:
„Funktioniert diese Struktur auch dann noch, wenn aus einem Datensatz zehn werden?“
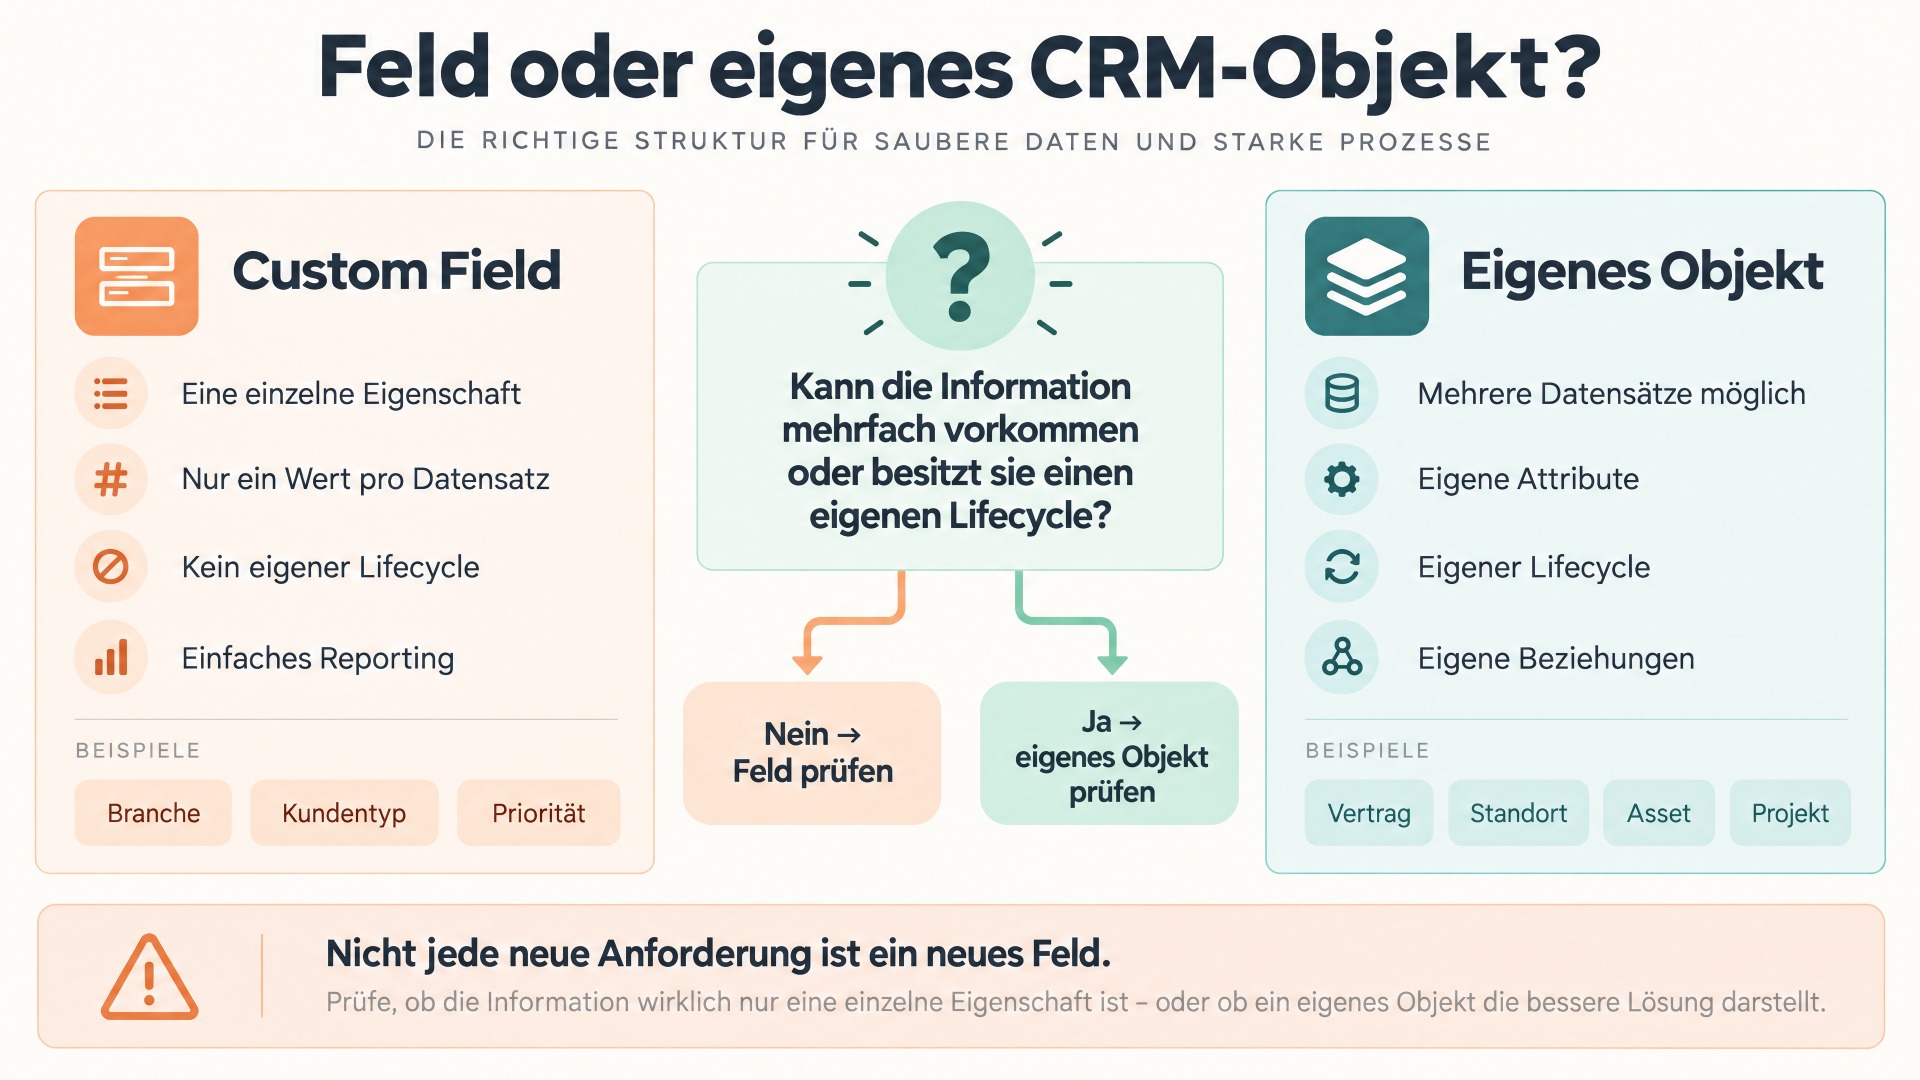
Custom Field oder eigenes CRM-Objekt?
Das ist eine der wichtigsten Entscheidungen in CRM-Projekten.
Nicht jede neue Information benötigt ein eigenes Modul. Gleichzeitig sollte aber auch nicht jede Anforderung in ein zusätzliches Feld gepresst werden.
Eine hilfreiche Faustregel lautet:
Wenn eine Information einen eigenen Lifecycle, mehrere Attribute oder mehrere Vorkommen pro Datensatz besitzt, sollte geprüft werden, ob sie ein eigenes Objekt benötigt.
Ein Beispiel:
Ein Unternehmen möchte Vertragsinformationen im CRM speichern.
Eine einfache Lösung könnte sein:
- Vertragsnummer
- Vertragsbeginn
- Vertragsende
- Vertragswert
als Felder direkt am Account.
Das funktioniert, solange jeder Kunde genau einen Vertrag besitzt.
Sobald mehrere Verträge existieren können, wird die Struktur problematisch.
Dann wäre ein eigenes Objekt „Vertrag“ meist sinnvoller.
Jeder Vertrag kann anschließend eigene Informationen besitzen:
- Vertragsnummer
- Startdatum
- Enddatum
- Status
- Wert
- Kündigungsfrist
- Produkte
- Ansprechpartner
- Dokumente
Und ein Account kann mit mehreren Verträgen verbunden sein.
Relationen sind wichtiger als zusätzliche Felder
Viele CRM-Systeme erlauben problemlos hunderte zusätzliche Felder. Technisch ist das einfach. Architektonisch ist es oft nicht die beste Lösung.
Ein CRM gewinnt seinen Wert insbesondere durch Beziehungen.
Ein Ansprechpartner gehört zu einem Unternehmen.
Eine Opportunity betrifft einen Kunden.
Eine Opportunity kann mehrere Ansprechpartner enthalten.
Ein Servicefall betrifft möglicherweise ein bestimmtes Produkt beim Kunden.
Ein Partner beeinflusst eventuell eine Opportunity.
Ein Projekt basiert auf einer gewonnenen Opportunity.
Wenn solche Zusammenhänge als echte Relationen modelliert werden, entstehen neue Auswertungsmöglichkeiten.
Das CRM kann dann beispielsweise beantworten:
- Welche Produkte besitzt dieser Kunde?
- Welche Servicefälle gab es für dieses Produkt?
- Welche Ansprechpartner sind an einem Vertrag beteiligt?
- Welche Opportunities wurden durch einen bestimmten Partner beeinflusst?
- Welche Projekte entstanden aus gewonnenen Opportunities?
Werden dieselben Informationen nur in Text- oder Dropdown-Feldern gespeichert, gehen diese Beziehungen verloren.
1:n und n:m richtig unterscheiden
Eine wichtige Designentscheidung betrifft die Kardinalität einer Beziehung.
1:n – Ein Datensatz zu vielen anderen
Beispiel:
Ein Account besitzt mehrere Ansprechpartner.
Das ist meist eine klassische 1:n-Beziehung.
n:m – Viele Datensätze auf beiden Seiten
Beispiel:
Mehrere Ansprechpartner können an mehreren Opportunities beteiligt sein.
Dann ist eine n:m-Beziehung sinnvoll.
Das gleiche gilt häufig für:
- Opportunities ↔ Partner
- Kontakte ↔ Projekte
- Produkte ↔ Verträge
- Accounts ↔ Unternehmensgruppen
- Mitarbeiter ↔ Kundenrollen
Gerade n:m-Beziehungen werden in frühen CRM-Konzepten häufig unterschätzt.
Später werden deshalb Zusatzfelder wie „Partner 1“, „Partner 2“ und „Partner 3“ eingeführt.
Das funktioniert kurzfristig, skaliert aber schlecht.
Wenn die Beziehung selbst Informationen besitzt
Noch interessanter wird es, wenn nicht nur die beiden Datensätze relevant sind, sondern auch die Beziehung zwischen ihnen.
Beispiel:
Eine Opportunity ist mit einem Partner verbunden.
Zusätzlich soll gespeichert werden:
- Rolle des Partners
- Beteiligungsdatum
- Sourced oder Influenced
- Provisionssatz
- Deal Protection
- Status der Zusammenarbeit
Dann reicht eine einfache Beziehung häufig nicht mehr.
Die Beziehung selbst benötigt Daten.
In solchen Fällen kann ein eigenes Zwischenobjekt sinnvoll sein, beispielsweise:
Opportunity Partner
Dieses Objekt verbindet Opportunity und Partner und speichert zusätzliche Informationen über genau diese Beziehung.
Dieses Prinzip ist extrem wertvoll für komplexere CRM-Datenmodelle.
Die zehn wichtigsten Bausteine eines nachhaltigen CRM-Datenmodells
| Nr. | Baustein | Kernfrage | Typischer Nutzen |
|---|---|---|---|
| 1 | Klare Geschäftsobjekte | Welche realen Dinge müssen eigenständig verwaltet werden? | Verhindert überladene Standardmodule |
| 2 | Eindeutige Definitionen | Was bedeutet Account, Lead, Opportunity oder Kunde? | Einheitliche Nutzung im Unternehmen |
| 3 | Saubere Beziehungen | Welche Objekte gehören fachlich zusammen? | Bessere 360°-Sicht und Auswertungen |
| 4 | Richtige Kardinalität | 1:1, 1:n oder n:m? | Verhindert spätere Strukturprobleme |
| 5 | Eigene Objekte statt Feldsammlungen | Kann die Information mehrfach auftreten oder besitzt sie einen Lifecycle? | Bessere Skalierbarkeit |
| 6 | Klare Statusmodelle | Welche Zustände kann ein Objekt durchlaufen? | Automatisierbare Prozesse |
| 7 | Verantwortlichkeit | Wer besitzt und pflegt den Datensatz? | Höhere Datenqualität |
| 8 | System-of-Record-Prinzip | Welches System ist führend für welche Daten? | Stabilere Integrationen |
| 9 | Reporting-Fähigkeit | Welche Fragen müssen später beantwortet werden? | Verhindert teure Reporting-Workarounds |
| 10 | Erweiterbarkeit | Welche zukünftigen Prozesse sind wahrscheinlich? | Weniger spätere Sonderentwicklung |
Statusfelder sind ebenfalls Teil des Datenmodells
Nicht nur Objekte und Beziehungen gehören zum Datenmodell.
Auch Status- und Lifecycle-Modelle müssen sauber definiert werden.
Ein Lead könnte beispielsweise folgende Phasen besitzen:
Neu → In Bearbeitung → Qualifiziert → Disqualifiziert → Konvertiert
Ein Partner:
Interessent → Qualifizierung → Onboarding → Aktiv → Inaktiv
Ein Vertrag:
Entwurf → Aktiv → Verlängerung → Gekündigt → Beendet
Das Problem beginnt, wenn Statuswerte lediglich historisch wachsen.
Nach einigen Jahren existieren dann beispielsweise:
- Neu
- Offen
- In Bearbeitung
- Bearbeitung
- Aktiv
- Aktiviert
- Wartend
- On Hold
- Zurückgestellt
ohne klar definierte Bedeutung.
Damit werden Automatisierung und Reporting unnötig kompliziert.
Jeder Status sollte deshalb eine eindeutige fachliche Bedeutung besitzen.
Das Datenmodell muss Reporting von Anfang an berücksichtigen
Eine gute Frage während des CRM-Designs lautet:
„Welche Managementfragen müssen wir später beantworten können?“
Zum Beispiel:
- Wie viel Pipeline besitzen wir je Kundengruppe?
- Welche Produkte werden bei welchen Kunden eingesetzt?
- Welche Opportunities hängen an auslaufenden Verträgen?
- Welche Partner beeinflussen unseren Umsatz?
- Welche Kunden besitzen offene Servicefälle und gleichzeitig Renewal-Potenzial?
- Wie entwickelt sich ein Account über mehrere Gesellschaften hinweg?
Wenn solche Fragen erst nach dem Go-live gestellt werden, stellt sich manchmal heraus, dass die benötigten Zusammenhänge überhaupt nicht strukturiert gespeichert werden.
Dann entsteht Reporting durch:
- Hilfsfelder,
- Exporte,
- SQL-Sonderlogik,
- Data Warehouses,
- manuelle Zuordnungen.
Deshalb sollte Reporting nicht erst am Ende des Projekts betrachtet werden.
Reporting beginnt beim Datenmodell.
CRM und ERP: Wer besitzt welche Daten?
Ein weiteres Problem entsteht häufig bei Integrationen.
CRM und ERP speichern teilweise dieselben Informationen:
- Firmenname
- Adresse
- Kundennummer
- Produkte
- Preise
- Ansprechpartner
- Aufträge
- Rechnungen
Die entscheidende Frage lautet deshalb nicht:
„Welche Daten synchronisieren wir?“
Sondern zuerst:
„Welches System ist für welche Information führend?“
Beispielsweise:
| Datenbereich | Typisches führendes System |
|---|---|
| Leads | CRM |
| Verkaufschancen | CRM |
| Vertriebsaktivitäten | CRM |
| Kundennummer | ERP |
| Rechnungen | ERP |
| Lieferstatus | ERP |
| Kommunikationshistorie | CRM |
| Servicefälle | CRM oder Serviceplattform |
Das tatsächliche Modell hängt selbstverständlich von der jeweiligen Systemlandschaft ab.
Wichtig ist die Eindeutigkeit.
Wenn CRM und ERP dieselbe Information gleichzeitig unabhängig verändern dürfen, entstehen früher oder später Konflikte.
Stammdaten und Bewegungsdaten unterscheiden
Eine weitere hilfreiche Trennung besteht zwischen Stammdaten und Transaktions- beziehungsweise Bewegungsdaten.
Stammdaten ändern sich vergleichsweise selten:
- Firmenname
- Branche
- Anschrift
- Kundennummer
- Ansprechpartner
- Produktdefinitionen
Bewegungsdaten entstehen kontinuierlich:
- Opportunities
- Aktivitäten
- Angebote
- Aufträge
- Servicefälle
- Interaktionen
Diese Unterscheidung hilft insbesondere bei Integrationen, Berechtigungen, Historisierung und Datenarchivierung.
Unternehmenshierarchien nicht unterschätzen
Im B2B-CRM gehören Account-Hierarchien zu den häufig unterschätzten Anforderungen.
Ein internationaler Kunde kann beispielsweise bestehen aus:
Global Holding
↓
Deutschland GmbH
↓
Werk Stuttgart
↓
Abteilung Produktion
Gleichzeitig existieren Kontakte, Opportunities, Verträge und Servicefälle auf unterschiedlichen Ebenen.
Das Management möchte möglicherweise den gesamten Konzernumsatz sehen.
Der Account Manager interessiert sich dagegen für Deutschland.
Der Servicemitarbeiter benötigt den einzelnen Standort.
Deshalb sollte früh geklärt werden:
- Welche Hierarchieebenen benötigen wir?
- Wo hängen Opportunities?
- Wo hängen Verträge?
- Wo werden Umsätze aggregiert?
- Welche Ebene besitzt der Ansprechpartner?
- Wie wird die Konzernsicht hergestellt?
Ein nachträglicher Umbau solcher Strukturen ist deutlich aufwendiger als eine frühe saubere Modellierung.
Dubletten sind häufig auch ein Datenmodellproblem
Dubletten werden meist als Datenqualitätsproblem betrachtet.
Teilweise sind sie jedoch ein Symptom eines unklaren Modells.
Wenn niemand weiß, ob Niederlassungen eigene Accounts oder nur Adressen eines bestehenden Accounts sind, entstehen zwangsläufig unterschiedliche Datensätze.
Wenn ein „Kunde“ einmal als Konzern und einmal als Gesellschaft verstanden wird, können selbst perfekte Dublettenregeln das Problem nicht vollständig lösen.
Datenqualität beginnt deshalb mit einer klaren Definition der Objekte.
Rollen gehören nicht in Freitextfelder
Gerade im B2B-CRM können Kontakte unterschiedliche Rollen besitzen.
Ein Ansprechpartner kann sein:
- Entscheider
- technischer Ansprechpartner
- Einkauf
- Champion
- Nutzer
- Vertragskontakt
- Rechnungsempfänger
Dabei ist entscheidend:
Eine Person kann gegenüber verschiedenen Opportunities oder Verträgen unterschiedliche Rollen besitzen.
Ein Kontakt kann bei Opportunity A Entscheider sein und bei Opportunity B lediglich technischer Ansprechpartner.
Deshalb gehört die Rolle nicht zwingend als festes Feld an den Kontakt.
In komplexeren Modellen kann sie eine Eigenschaft der Beziehung zwischen Kontakt und Opportunity sein.
Das ist ein klassisches Beispiel dafür, warum gutes Datenmodellieren über das reine Erstellen von Feldern hinausgeht.
CRM: Flexibilität sinnvoll nutzen
Plattformen wie SugarAI oder SpiceCRM bieten umfangreiche Möglichkeiten, bestehende Module zu erweitern, zusätzliche Felder anzulegen, Beziehungen aufzubauen und eigene fachliche Strukturen abzubilden.
Genau diese Flexibilität ist wertvoll.
Sie birgt aber auch ein Risiko.
Nur weil sich ein neues Feld schnell anlegen lässt, bedeutet das nicht automatisch, dass ein Feld die richtige fachliche Lösung ist.
Vor Customizing sollte daher immer die Frage gestellt werden:
Ist das eine zusätzliche Eigenschaft eines bestehenden Objekts – oder entsteht hier eigentlich ein neues Geschäftsobjekt?
Ein eigener Datentyp oder ein eigenes Modul verursacht zunächst mehr Modellierungsaufwand. Langfristig kann es Reporting, Workflows, Berechtigungen und Integrationen aber erheblich vereinfachen.
KI macht ein gutes CRM-Datenmodell noch wichtiger
Mit KI gewinnt das Thema zusätzlich an Bedeutung.
Ein KI-Assistent kann CRM-Informationen zusammenfassen.
Ein Agent kann eventuell Meetings vorbereiten, Opportunity-Risiken identifizieren oder nächste Schritte vorschlagen.
Aber die Qualität dieser Funktionen hängt vom Kontext ab.
Wenn beispielsweise klar strukturiert ist:
- welche Produkte ein Kunde besitzt,
- welche Verträge aktiv sind,
- welche Ansprechpartner welche Rollen spielen,
- welche Opportunities laufen,
- welche Serviceprobleme bestehen,
kann KI wesentlich präziser arbeiten.
Sind dieselben Informationen dagegen über Freitextfelder, Notizen, Anhänge und nicht verknüpfte Datensätze verteilt, muss die KI zunächst versuchen, Zusammenhänge zu rekonstruieren.
Ein gutes Datenmodell ist deshalb auch eine Grundlage für AI-ready CRM.
Typische Fehler bei CRM-Datenmodellen
| Fehler | Kurzfristige Wirkung | Langfristige Folge |
|---|---|---|
| Zu viele Custom Fields | Schnell umgesetzt | Unübersichtliche Masken und schlechte Skalierung |
| Mehrfachwerte in einem Feld | Einfach zu pflegen | Kaum sauber auswertbar |
| Partner 1 / Partner 2 / Partner 3 | Funktioniert zunächst | Starres Modell bei mehr Beteiligten |
| Keine Account-Hierarchie | Weniger Komplexität | Keine zuverlässige Konzernsicht |
| Statuswerte ohne Definition | Flexibel | Inkonsistentes Reporting |
| CRM und ERP ohne Datenverantwortung | Schnelle Integration | Synchronisationskonflikte |
| Freitext statt Relationen | Schnelle Datenerfassung | Fehlende Automatisierung und Auswertung |
| Alles im Account-Modul | Wenige Module | Überladene Datensätze |
| Reporting erst nach Go-live planen | Schneller Projektstart | Teure Nachbesserung |
| Nur heutige Anforderungen modellieren | Kleines Initialprojekt | Früher struktureller Umbau |
Praxisbeispiel: Vom überladenen Account zum skalierbaren Modell
Ein mittelständisches B2B-Unternehmen nutzt sein CRM seit mehreren Jahren.
Am Account befinden sich inzwischen mehr als 150 individuelle Felder.
Darunter:
- Vertragsbeginn
- Vertragsende
- Produktgruppe
- installierte Lösung
- Standort
- Projektstatus
- Servicelevel
- Partner
- Renewal-Datum
Ursprünglich funktionierte dieses Modell, weil die meisten Kunden nur einen Vertrag und einen Standort hatten.
Das Geschäftsmodell entwickelt sich jedoch weiter.
Ein Kunde kann inzwischen mehrere Verträge, Standorte und Lösungen besitzen. Zusätzlich werden Customer Success und Partnervertrieb aufgebaut.
Das Problem:
Ein einziges Vertragsende-Feld kann nicht mehr abbilden, dass drei Verträge zu unterschiedlichen Terminen auslaufen.
Ein einzelnes Partnerfeld kann nicht zeigen, dass mehrere Partner unterschiedliche Rollen bei verschiedenen Opportunities übernehmen.
Und ein einzelnes Produktfeld liefert keine echte Installed-Base-Sicht.
Das Unternehmen überarbeitet deshalb das Datenmodell.
| Phase | Änderung am Datenmodell | Ergebnis |
|---|---|---|
| Phase 1 | Vertragsfelder werden durch ein eigenes Objekt „Vertrag“ ersetzt. | Mehrere Verträge pro Kunde können sauber verwaltet werden. |
| Phase 2 | Installierte Produkte werden als Assets bzw. Kundenprodukte modelliert. | Installed Base, Service und Cross-Selling werden besser auswertbar. |
| Phase 3 | Standorte werden strukturiert mit Accounts verbunden. | Konzern- und Standortperspektive können getrennt betrachtet werden. |
| Phase 4 | Partner werden relational mit Opportunities verknüpft. | Mehrere Partner und unterschiedliche Rollen werden abbildbar. |
| Phase 5 | Reporting und Workflows werden auf Beziehungen statt Hilfsfelder aufgebaut. | Weniger Sonderlogik und bessere Erweiterbarkeit. |
Das Ergebnis ist nicht zwangsläufig ein CRM mit weniger Daten.
Es ist ein CRM mit klarer strukturierten Daten.
Und genau das reduziert langfristig Komplexität.
Checkliste: Ist Ihr CRM-Datenmodell zukunftsfähig?
- Ist eindeutig definiert, was ein Kunde beziehungsweise Account ist?
- Sind Unternehmen, Standorte und Konzernstrukturen sauber getrennt?
- Ist geklärt, welche Informationen eigene Objekte benötigen?
- Werden Mehrfachinformationen nicht in einzelnen Feldern gespeichert?
- Sind 1:n- und n:m-Beziehungen fachlich korrekt modelliert?
- Können Beziehungen eigene Attribute besitzen, wenn dies notwendig ist?
- Sind Statuswerte eindeutig definiert?
- Sind Verantwortlichkeiten für Datensätze festgelegt?
- Ist definiert, welches System für welche Daten führend ist?
- Sind CRM- und ERP-Daten sauber abgegrenzt?
- Können Reporting-Fragen direkt aus dem Datenmodell beantwortet werden?
- Funktioniert das Modell auch bei mehreren Verträgen, Produkten oder Standorten?
- Können neue Partnerrollen und Geschäftsmodelle ergänzt werden?
- Lassen sich Prozesse auf den Beziehungen automatisieren?
- Ist das Modell auch für KI-Anwendungen ausreichend strukturiert?
- Werden Custom Fields regelmäßig überprüft?
- Gibt es Namens- und Modellierungskonventionen?
- Ist dokumentiert, warum wichtige Objekte und Beziehungen existieren?
- Wird bei neuen Anforderungen zuerst das Datenmodell geprüft?
- Kann das CRM wachsen, ohne bestehende Strukturen regelmäßig neu bauen zu müssen?
Fazit: Gute CRM-Architektur beginnt vor dem ersten Custom Field
Ein schlechtes Datenmodell verursacht selten sofort sichtbare Probleme.
Es erzeugt vielmehr schleichende Kosten.
Neue Anforderungen benötigen immer mehr Sonderlogik. Reporting wird komplizierter. Schnittstellen müssen Sonderfälle behandeln. Benutzer pflegen Informationen mehrfach und Automatisierungen werden zunehmend fragil.
Deshalb lohnt es sich, bereits am Anfang mehr Zeit in die Modellierung zu investieren.
Ein gutes CRM-Datenmodell beantwortet drei Fragen:
Welche Geschäftsobjekte existieren?
Wie stehen diese Objekte miteinander in Beziehung?
Wie kann sich dieses Modell mit dem Unternehmen weiterentwickeln?
Wer diese Fragen sauber beantwortet, baut nicht nur ein CRM für den aktuellen Prozess.
Er schafft eine Plattform, auf der sich neue Vertriebsmodelle, Serviceprozesse, Integrationen und KI-Anwendungen deutlich leichter entwickeln lassen.